CODEXGUIDE / 项目理解与上下文 02
给 Codex 多大上下文才够用:三组实验的结果
用 Codex 处理任务时,上下文给多少,直接决定它先做什么。给少了,它反复追问;给多了,它要在噪声里翻找目标;给到刚好,它能直接定位问题。
配图采集环境:macOS 15.7.5(Build 24G624);Codex/ChatGPT App 26.721.41059;2026-08-21 核验。Codex 三组实验在 Windows 环境完成,正文会单独说明。
上下文给多少,决定它先做什么
用 Codex 处理任务时,上下文给多少,直接决定它先做什么。给少了,它反复追问;给多了,它要在噪声里翻找目标;给到刚好,它能直接定位问题。
为了弄清“刚好”是多少,我用同一个任务设计了三组输入:信息不足、信息过量和最小充分上下文,分别交给 Codex 处理,对比它的调查路线、追问次数和最终判断。这篇文章是三组真实实验的记录。
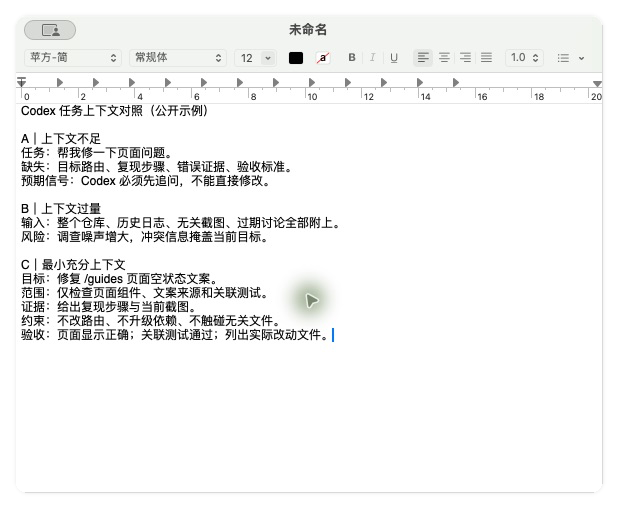
图一 上下文不足、过量和最小充分三种输入,对应三种完全不同的任务开局。
三种输入长什么样
实验任务是一个公开示例问题:修复加法结果的显示错误。三组输入的差异只在信息量,任务本身完全相同。
图二 三组输入的结构对照:A 组缺关键信息,B 组把仓库整个倒进去,C 组只给目标、范围、证据和验收。
A 组只说“帮我修一下页面问题”,缺目标路由、复现步骤、错误证据和验收标准,预期信号是 Codex 必须先追问,不能直接修改。B 组把整个仓库、历史日志、无关截图和过期讨论全部附上,风险是调查噪声增大,冲突信息掩盖当前目标。C 组给出明确目标、检查范围、复现证据、约束条件和验收方式。
这里先纠正一个常见误解:模型的上下文窗口上限不是推荐输入量。窗口能装下,不等于装进去有帮助。B 组那种“反正都给它”的做法,恰恰是实验里噪声最大的一组。
第一组:信息不足,Codex 会怎么做
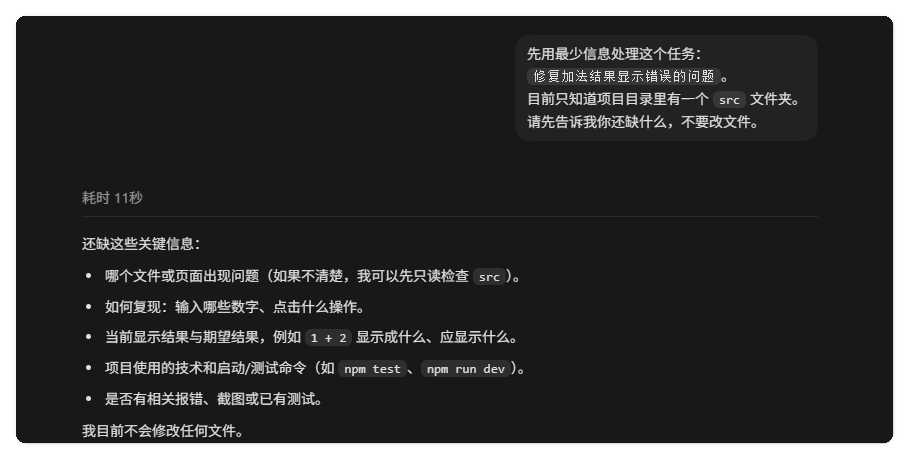
A 组输入只有一句话加一个目录线索:修复加法结果显示错误的问题,目前只知道项目目录里有一个 src 文件夹。我同时要求它先告诉我还缺什么,不要改文件。
图三 信息不足时,Codex 用 11 秒列出了还缺的关键信息,没有修改任何文件。
Codex 没有猜,而是列出五类缺失信息:哪个文件或页面出现问题、如何复现、当前显示结果与期望结果、项目的技术栈和启动/测试命令、是否有相关报错或已有测试。最后还主动提出,如果不清楚文件位置,它可以先只读检查 src。
这个反应是正确的开局。信息不足时,可靠的行为是追问和提议只读调查,而不是直接动手。如果你的任务描述只有一句话,看到它开始大范围修改,反而应该停下来。
第二组:信息过量,噪声从哪来
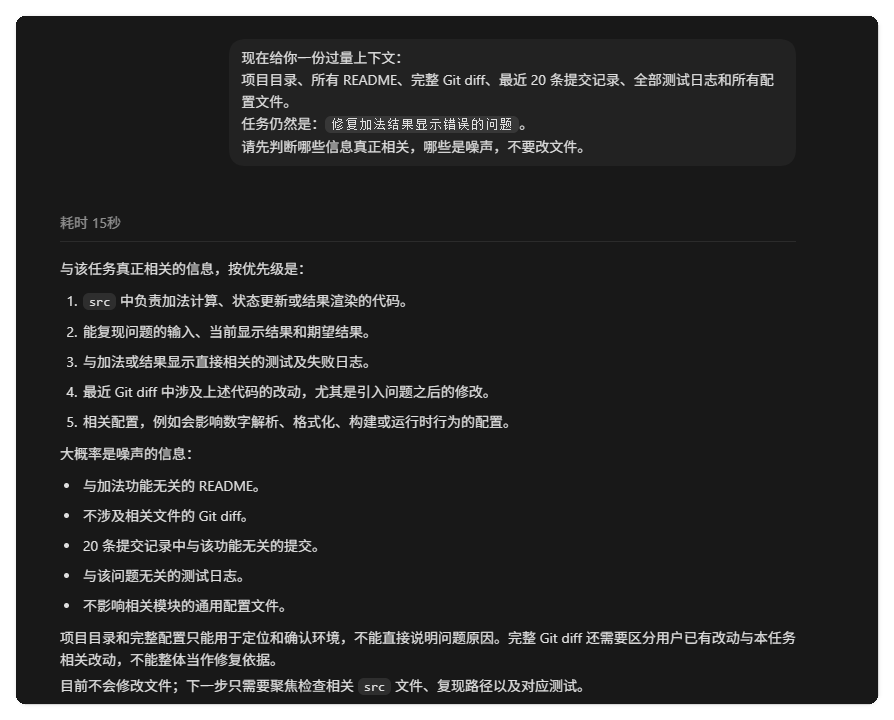
B 组输入是另一个极端:项目目录、所有 README、完整 Git diff、最近 20 条提交记录、全部测试日志和所有配置文件,任务不变,让它先判断哪些信息真正相关。
图四 面对过量材料,Codex 先按相关性把信息分成“真正相关”和“大概率是噪声”两类。
Codex 把 src 中负责加法计算和结果渲染的代码、复现输入、相关测试和涉及这些代码的 Git diff 列为相关;把无关的 README、不涉及相关文件的 diff、无关提交和通用配置归为噪声。它还特别指出两点:项目目录和完整配置只能用于定位环境,不能直接说明问题原因;完整 Git diff 还要区分用户已有改动和本任务相关改动,不能整体当作修复依据。
这组实验说明,过量上下文不会直接让结果出错,但会把第一轮时间花在筛选上,而且噪声里的冲突信息(比如过期讨论里的旧结论)随时可能带偏判断。信息多不等于信息足。
第三组:最小充分上下文
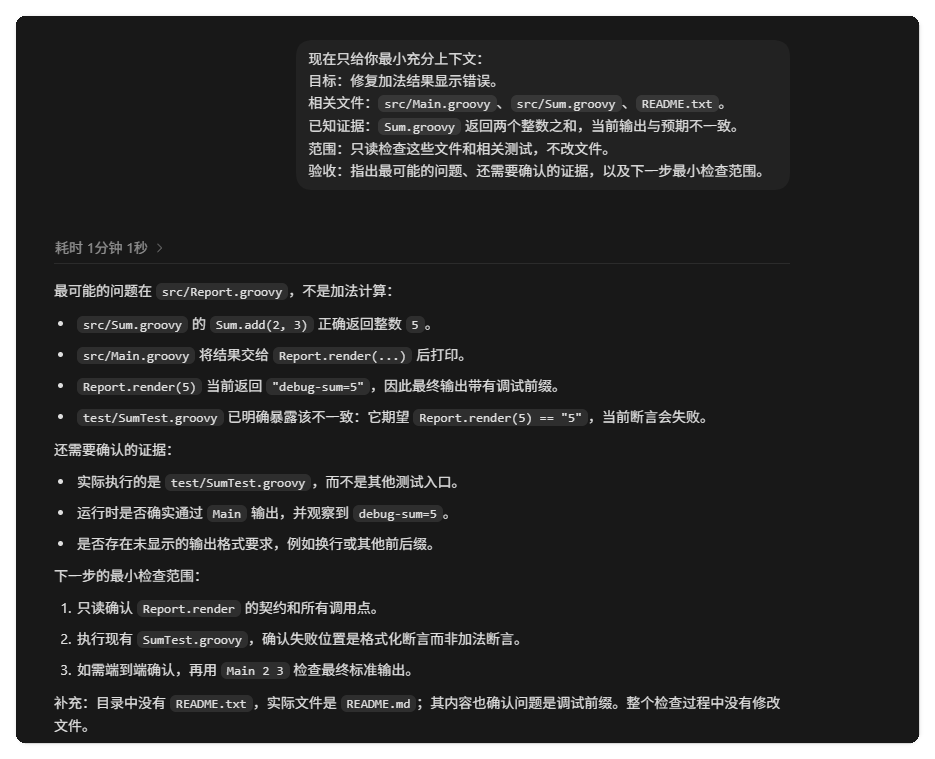
C 组输入只有五样东西:目标(修复加法结果显示错误)、相关文件(src/Main.groovy、src/Sum.groovy、README.txt)、已知证据(Sum.groovy 返回两个整数之和,当前输出与预期不一致)、范围(只读检查这些文件和相关测试,不改文件)、验收(指出最可能的问题、还需要确认的证据和下一步最小检查范围)。
图五 最小充分输入下,Codex 直接把问题定位到 src/Report.groovy,并列出仍需确认的证据。这一轮 Codex 没有追问,直接给出判断:最可能的问题在 src/Report.groovy,不是加法计算。Sum.add(2, 3) 正确返回整数 5,Report.render(5) 当前返回 "debug-sum=5",测试 test/SumTest.groovy 期望 "5",当前断言会失败。
两个细节值得注意。一是它列出了仍需确认的证据:实际执行的是哪个测试入口、运行时是否真的观察到 debug-sum=5、是否有未说明的输出格式要求。定位到结论不等于跳过验证。二是它发现一个输入错误:我写的相关文件是 README.txt,目录里实际只有 README.md,它在补充说明里纠正了这一点。给对范围,它不仅能定位问题,还能反过来校正你的输入。
如果你还不确定什么样的任务适合先让 Codex 只读检查,可以对照《第一次让 Codex 改项目,我建议你先从这个小任务开始》里的任务尺度。
三组结果放在一起
三轮跑完,我让 Codex 把结果整理成对照表,并明确要求:不要把模型上下文上限写成推荐输入量。
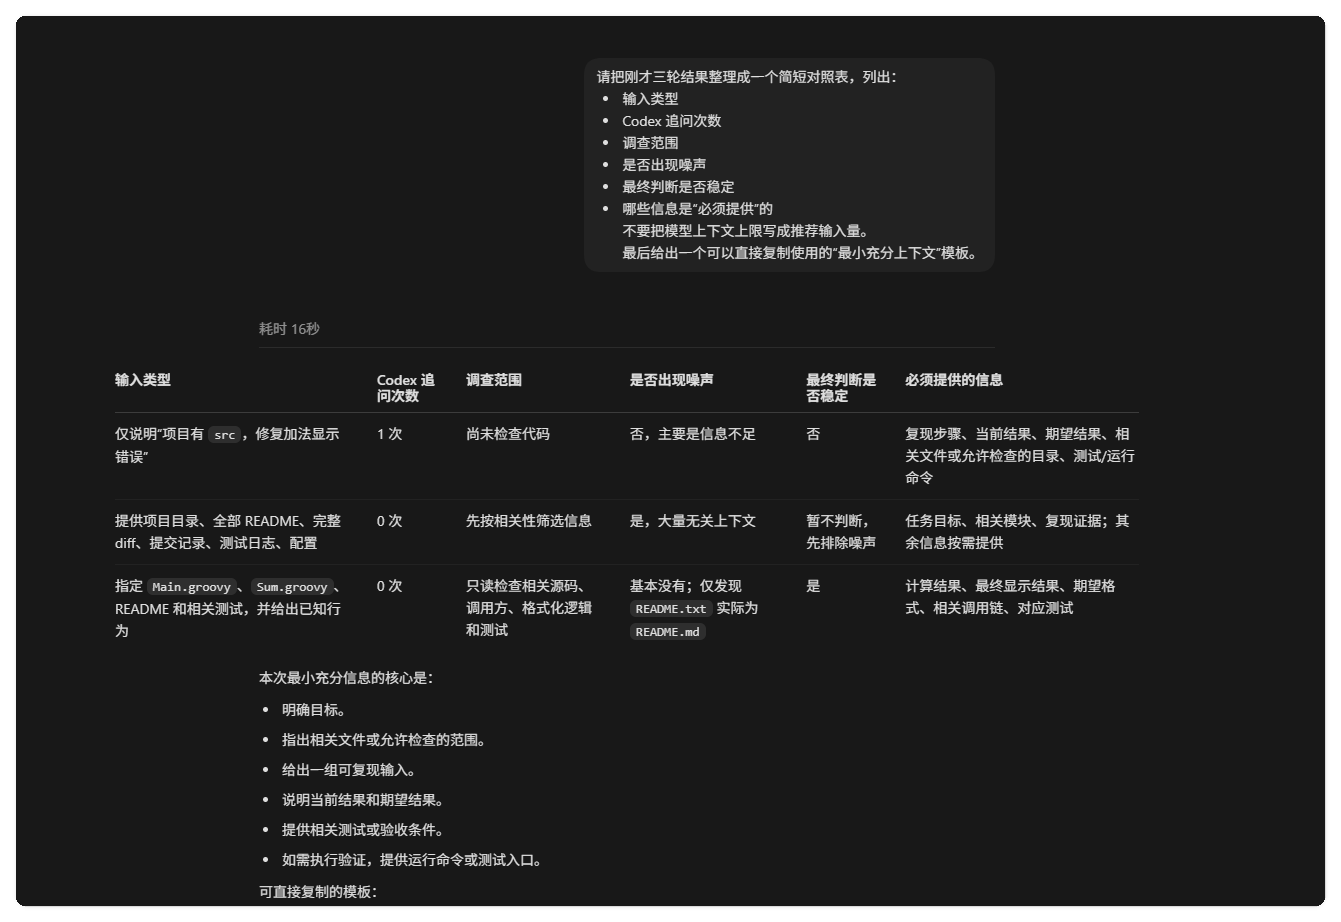
图六 三组输入的追问次数、调查范围、噪声和判断稳定性对照。
对照结果很直观。A 组追问 1 次,调查范围是“尚未检查代码”,判断不稳定,缺的是复现步骤、当前结果、期望结果和允许检查的目录。B 组追问 0 次,但第一轮时间花在按相关性筛选信息上,出现大量无关上下文,判断需要先排除噪声。C 组追问 0 次,调查只读覆盖相关源码、调用方、格式化逻辑和测试,基本没有噪声,最终判断稳定。
最小充分信息的核心,Codex 总结为六条:明确目标;指出相关文件或允许检查的范围;给出一组可复现输入;说明当前结果和期望结果;提供相关测试或验收条件;如需执行验证,提供运行命令或测试入口。
可以直接复制的模板
实验最后产出了一个可直接复制的最小充分上下文模板。
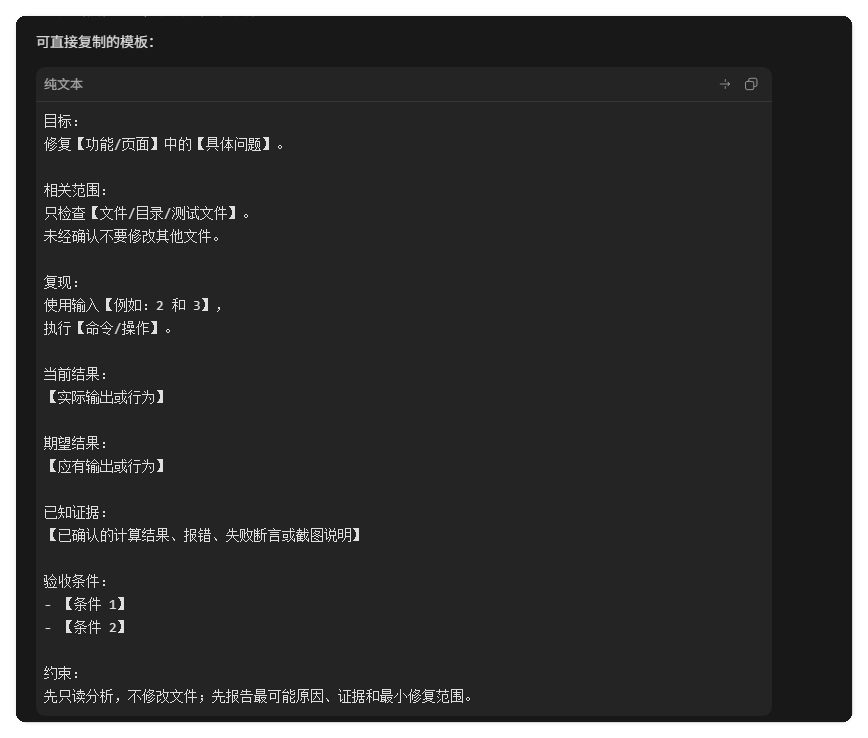
图七 模板包含目标、相关范围、复现、当前结果、期望结果、已知证据、验收条件和约束八个部分。
模板原文如下,把方括号换成你的任务信息即可:
目标:
修复【功能/页面】中的【具体问题】。

相关范围:
只检查【文件/目录/测试文件】。
未经确认不要修改其他文件。

复现:
使用输入【例如:2 和 3】,
执行【命令/操作】。

当前结果:
【实际输出或行为】

期望结果:
【应有输出或行为】

已知证据:
【已确认的计算结果、报错、失败断言或截图说明】

验收条件:
- 【条件 1】
- 【条件 2】

约束:
先只读分析,不修改文件;先报告最可能原因、证据和最小修复范围。
实际使用时不用机械填满每一项。没有报错日志就不写,但“目标、范围、当前结果、期望结果”这四项几乎总是必须的——它们正是 A 组缺失、导致追问的那部分。
分轮补充,而不是一次倒完
如果一开始给不齐最小充分上下文,也不用把整个仓库倒进去补救。更好的做法是分轮补充:第一轮给目标和范围,看 Codex 追问什么;第二轮只补它追问的内容;它不再追问、开始给出可核对的事实时,信息基本就够了。
停止继续堆叠信息的信号有三个:它的提问从“缺信息”变成“确认理解”;它给出的下一步是可执行的检查而不是继续索要材料;它开始区分事实、推断和待确认项。出现这些信号,再往上堆材料只会增加噪声。
这类“先调查、后执行”的节奏,和《别一上来就让 Codex 改项目,我已经替你踩过坑了》里讲的是同一个原则:让结论跑在修改前面。
小结
三组实验的结论可以压成一句话:上下文的质量按“够不够定位问题”衡量,不按字数衡量。不足时 Codex 会追问,这是正常信号;过量时它先筛噪声,冲突信息可能带偏判断;最小充分输入是目标、范围、复现、当前结果、期望结果、证据、验收和约束这八项的按需组合。
下次给 Codex 派任务前,可以先对照模板检查一遍输入,缺的补上,多的删掉。
这套模板适合在任务开始前快速检查输入质量:缺信息时分轮补充,信息足够后就停止继续堆叠。